Cloudflare 的 Clef 能让程序直接拿到派单、分级和筛选结果,省掉让大模型写出答案、再解析文字的步骤。但我读完发布博客、追到公开实现后,最想提醒接入者的是:模型返回的数值,需要保留它原本的含义。
我运行官方输出转换函数,把两种分布送进去:一种确定属于中档;另一种一半属于低档、一半属于高档。两者的 score 都是 1.0。如果系统只保存这个平均值,就会把明确判断和两极分歧压成同一个结果。
同一份材料 + 问题与候选项
        ↓
Qwen 读入全文 → 联合评分头 → 每题的候选概率
                                      ↓
                           业务规则决定执行或转人工
这篇以 Cloudflare 2026 年 10 月 1 日的发布文章为起点,补充公开源码核对、输出函数实验和表格复算。没有运行 Clef 模型权重,也没有测 Workers AI 的真实网络延迟;下面会把函数行为与模型能力分开。
先声明候选项,才能省掉逐字生成
设想客服收到:生产支付接口持续报错,所有客户无法结账。程序需要三个判断:是否紧急、交给哪个团队、影响多严重。
Clef 的请求分成 state 和 questions。前者是待判断的材料,可以是文字或结构化对象;后者声明问题以及答案范围。这里的 schema 就是答案结构约定:哪些字段必须回答、每个字段允许哪些选项。
官方模型卡定义了三种类型:noul 返回“是”的概率;choice 在命名候选项中选择;score 对从 0 开始编号的有序档位计算加权平均。noul 是这套接口的类型名,不需要把它理解成另一种模型。
例如,团队问题可以这样写,这是完整请求中的一个字段:
{
  "team": {
    "type": "choice",
    "instructions": "Which team should handle the request?",
    "criteria": {
      "billing": "Payments, invoices, refunds without a service outage",
      "technical": "Service outages, errors, configuration problems",
      "unknown": "Insufficient evidence to route the request"
    }
  }
}
criteria 里的描述是判断依据的一部分。支付相关的故障可能同时符合 billing 和 technical,因此描述要交代如何区分。我在这里主动加入 unknown,让证据不足也有合法出口;这是一项接口设计建议,未实测 Clef 在该例上的表现。
Clef 之所以能直接评分,是因为答案集合在推理前已经给定。模型只需比较这些候选项,无须创造一个未声明的新答案。如果业务要生成事故复盘、写代码或抽取任意长度的自由文本,这个前提就消失了,仍需要生成模型承担后续工作。
这也解释了它与传统分类器的关系:两者都给类别打分;Clef 把问题和类别描述一起作为输入,使标签可以随请求变化。更早的交叉编码器也会联合阅读材料与候选项;Clef 在这条思路上加入共享主干、多字段交互和类型化输出。它能理解新标签的程度仍需测试,不能由接口形式保证。
本站的 Gemini Decision 1 API 实验讨论了同一类业务接口;本文的增量是沿 Clef 公开实现看清评分过程。两家的题间语义不能直接互相套用。
Qwen 读一次,评分头再让候选项找证据
普通自回归生成通常分为两步:prefill 一次读入输入;decode 逐步生成输出,每一步依赖之前生成的内容。Clef 保留读入阶段,随后用专门的评分头计算候选项分数,省去了逐字生成答案的循环。
原文披露 Clef 使用 Qwen3.8-27B,Clef-flash 使用 Qwen3.5-9B。它们保留视觉编码器,因此可以把图像信息也用于判断。这里的 27B、9B 是十亿参数量级,说明 flash 仍然是一个相当大的模型,不能从名称推断它能在普通电脑上轻松运行。
公开实现 joint_schema_model.py:462–491能验证读入路径:ClefModel.forward 调用主干,设置 use_cache=False,把最后一层内部表示交给评分头;这里没有调用逐字生成的 generate。
内部表示可以理解为模型读完材料后,为各输入位置形成的一组数值描述。评分头需要从这些描述中找到每个问题的证据。根据同文件的 JointSchemaHead:281–459,它大致做了这些事:
- 取出问题和选项对应的内部表示,并保留选项文字自身的语义表示。
- 让每个选项去读取输入中相关的信息;这就是原文所说的 evidence routing。
- 汇总每题的候选证据,让各字段继续互相交流,并再次读取输入。
- 结合文字语义的基础分与联合评分结果,为每个选项输出一个分数。
所谓 cross-attention,可以直观理解为拿着一个问题去材料里查相关证据;字段间的 attention 则允许“是否紧急”和“事故等级”交换信息。它们联合计算,意味着一次请求增加或修改问题,可能影响原有问题的结果。源码支持这种影响路径,例如,确认正在停服的证据可以参与事故等级评分;这描述的是计算中的信息交流,不代表模型必须先生成第一题答案。实际影响大小尚未测试。
最后,每题单独用 softmax 把分数转成概率:先把各分数变成正数,再除以总和,使该题所有选项加起来为 1。这里无需记公式,关键是它只在给定选项之间分配概率。即使所有选项都不合适,系统仍需要把这 1 分配完。
所以输出永远符合候选集合,与业务判断永远正确,是两项不同的保证。选项缺漏、材料被截断、输入里混入恶意指令,都不会因为省掉生成步骤就自动解决。
一个 score,确实能藏住两种完全不同的判断
模型卡说明 score 是期望值,也就是用概率作为权重计算平均档位。我想进一步确认:调用方最终会拿到什么,能否从这个值推断模型选中了哪个等级?
systemone_answer:523–543的实现很明确:score 是档位编号的加权和,confidence 是最大单档概率,同时返回完整分布。
下面的实验只运行该官方转换函数,不下载权重、不安装 PyTorch。用 Python 标准库取出函数的语法树节点再执行,可以隔离测试输出规则。网络下载的是固定提交版本,运行前可检查所链接的源码。
curl -L --fail -o joint_schema_model.py \
  https://huggingface.co/Cloudflare/clef/resolve/a20e258b170e7f7a9fae1fb58d7bb6e089f2ce29/joint_schema_model.py
python3 - <<'PY'
import ast
from typing import Any

source = ast.parse(open("joint_schema_model.py").read())
node = next(n for n in source.body
            if isinstance(n, ast.FunctionDef)
            and n.name == "systemone_answer")
scope = {"Any": Any}
exec(compile(ast.Module(body=[node], type_ignores=[]),
             "joint_schema_model.py", "exec"), scope)
question = {"type": "score", "criteria": ["low", "medium", "high"]}
for name, probs in [
    ("middle", {"0": 0.0, "1": 1.0, "2": 0.0}),
    ("polarized", {"0": 0.5, "1": 0.0, "2": 0.5}),
]:
    result = scope["systemone_answer"](question, probs)
    print(name, result["score"], result["confidence"], result["probabilities"])
PY
我本地执行该函数得到的结果,按上面格式摘出关键字段:
middle 1.0 1.0 {'0': 0.0, '1': 1.0, '2': 0.0}
polarized 1.0 0.5 {'0': 0.5, '1': 0.0, '2': 0.5}
这是人为构造的函数输入,用于验证信息压缩行为,不能当作 Clef 实际会输出这些分布的证据。第一种平均值是 1;第二种是 0×0.5 + 2×0.5 = 1,但第二种对“中等”的概率恰好为零。
因此,如果事故处置规则关注高危可能性,应检查高危档位或多个高危档位的概率之和,不能把平均值四舍五入后当成等级。另一个容易忽略的问题是:从低到中、从中到高的编号间距都为 1,实际损失却未必等距。平均等级应当配合完整分布展示,未必适合直接控制告警。
同样,源码里的 confidence 只是最大候选概率。它没有额外调用一个正确性验证器;它是否能代表可靠程度,需要另做校准测试;即使总体校准良好,也不构成单次正确性保证。
64k 上下文与本地默认入口,不是一回事
我核对到的另一处接入差异在输入处理。发布博客说上下文为 64k;Workers AI 当前模型文档列出 65,536 token。token 是模型处理文本的单位,一段中文或一个单词可能拆成多个单位,不能直接换算成字符数。
但公开 Python 实现里,encode_record 和 systemone 的默认 max_length 都是 16,384。这是本地辅助函数的默认预算,不是托管服务的上限,两条路径不能混读。
更值得注意的是 encode_record:103–196如何分配预算:先计算系统提示、媒体、问题和选项等固定部分的长度,再将 state 截到剩余长度,保留前面、舍弃后面。固定部分自己就超预算时才抛错。
我的推导是:在总预算不变时,增加问题和选项,会挤掉原本还能读到的材料尾部。这条接入风险由截断表达式直接得出,发布博客没有展开讲。若客服对话的最后一句才说明“已经恢复”,结果可能仍根据早先的宕机描述判断。
这不只是本地代码问题:托管文档也明确说,媒体和问题占用上下文,文本状态会截断到剩余空间。但本文没有验证托管服务具体采用怎样的截断方向,不能把本地实现的保留前缀行为直接归给云端。
接入时可把关键事实从原始长对话中单独整理出来,记录实际输入长度,并设计一个测试:把相同的关键事实分别放在材料开头和结尾,逐步加长输入。若两者判断开始分离,先检查模型是否真的读到了它,而不是立刻归因于推理能力。
报告值复算:中位延迟比为 5.39,p95 比为 1.95
对交互服务来说,慢请求可能比中位数更影响体验。下表是发布博客里的 Cloudflare 报告值,我没有重跑其服务评测。
| 指标 | Clef | Clef-flash | Jev |
|---|---|---|---|
| 中位延迟,毫秒 | 209.3 | 38.8 | 524.1 |
| p95 延迟,毫秒 | 238.6 | 122.4 | 536.0 |
| CLINC150+OOS,macro-F1 | 97.43 | 66.77 | 89.27 |
| 家电任务,完整案例准确率 | 82.95 | 97.73 | 52.27 |
| When2Call,准确率 | 72.37 | 65.58 | 80.97 |
中位数是排在中间的请求耗时;p95 是约 95% 请求不超过的耗时,用于观察较慢的那部分请求。macro-F1 先对每一类分别评价识别质量再平均,避免大类别完全掩盖小类别;它不能与另一行的准确率直接比较。
我用原文输入值做了复算,下面命令可直接运行:
python3 - <<'PY'
print("median speedup", round(209.3 / 38.8, 2))
print("p95 speedup", round(238.6 / 122.4, 2))
print("flash p95/median", round(122.4 / 38.8, 2))
print("CLINC gap", round(97.43 - 66.77, 2))
print("home flash lead", round(97.73 - 82.95, 2))
print("When2Call Jev lead", round(80.97 - 72.37, 2))
PY
实际输出:
median speedup 5.39
p95 speedup 1.95
flash p95/median 3.15
CLINC gap 30.66
home flash lead 14.78
When2Call Jev lead 8.6
这里的倍数是两个延迟统计量相除,并不代表每一条请求都获得同样加速,更不能换算成吞吐量倍数。但它足以说明:如果你关心最慢一批请求,中位延迟给出的印象会偏乐观。服务排队、并发和部署条件仍需要自己的评测。
换一个任务,模型的先后顺序就变了。Clef 在 CLINC150+OOS 上领先 flash 30.66 个百分点;flash 在家电任务上反而领先 Clef 14.78 个百分点;Jev 的 When2Call 领先 Clef 8.60 个百分点。CLINC150+OOS 包含领域外意图识别,但这行总指标不足以分离出具体是哪类样本造成差距。
不能把这些差值解释为有统计显著性的结论:发布表格没有在这里给出置信区间。而且不同任务的指标定义不同,随意求平均会掩盖业务真正关心的错误。
原文还报告网站抓取、渲染和分类合计耗时:Clef 为 2.2 秒,gpt-oss-120b 为 4.7 秒。这与上面的决策延迟表不是同一种测量范围。把浏览器也放进工作流后,减少模型时间只能改善总耗时中的一部分。
校准训练很有用,放行动作仍要另外验收
原文说,训练时冻结 Qwen 主干,同时优化评分头和 rank-256 的低秩适配器。低秩适配器是在主干旁用较少可训练参数学习调整;冻结主干不等于整个模型都没有学习。
训练目标包含标签平滑的交叉熵和 Brier loss。前者鼓励正确选项分数更高,同时避免把训练标签当作绝对无误;后者衡量预测概率与实际结果之间的平方差。比如一件事实际发生时,预测概率越接近 1,这部分误差越小。
校准的含义是:对大量被预测为约 80% 的事件,实际发生比例也接近 80%。它描述一批预测的统计性质,不是单次输出的证明。用 Brier loss 训练,有助于朝这个方向优化,却不保证迁移到你的客服、风控或安全数据后仍然成立。
原文还提出 RLCD,即针对校准决策的强化学习:相邻有序档位可得部分奖励,完整记录完全正确获得奖励,并用参考模型惩罚约束偏移。原文把 RLCD 描述为次级优化目标,但未在这里交代完整训练阶段顺序。本文没有训练代码和独立消融实验,无法判断各目标分别贡献多少收益。
落地时,至少要把业务规则与输出概率接起来。例如派单允许试错,停用账户则可能代价很高;同一个最大概率阈值不应自动通用于两者。涉及权限、金额上限、重复执行的检查,也应由程序确定性执行。
把这张图读成两条循环,才能看清训练发生在哪里
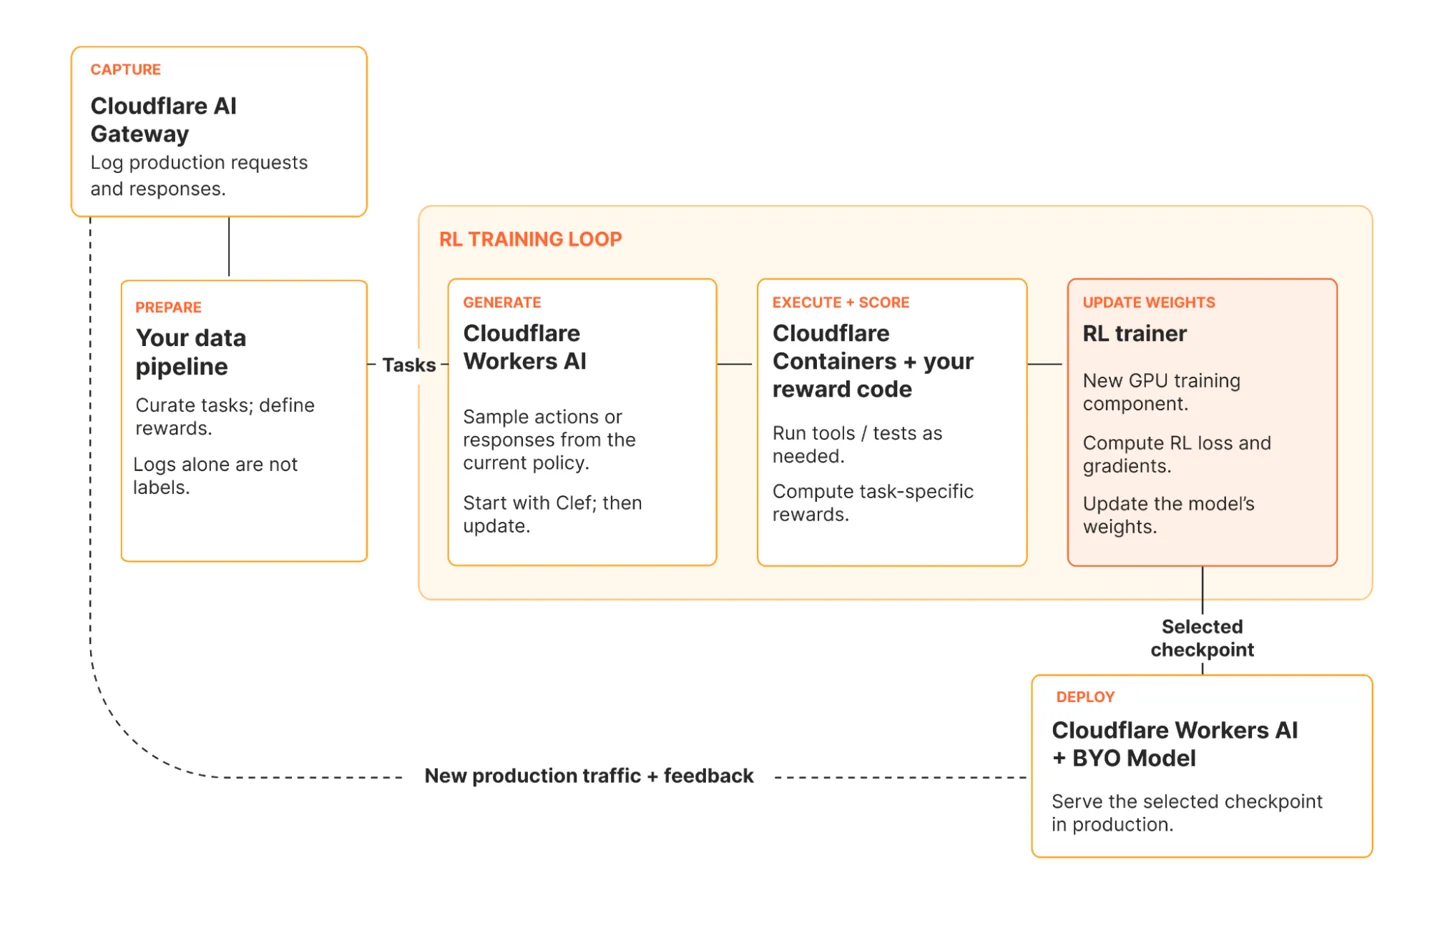
这张补充的流程示意图用于解读原文的客户微调服务与平台方向,并非前文 Clef 基础模型训练配方的披露。它把 Cloudflare 的基础设施分工画出来,也把业务方需要承担的工作留在了图上:Your data pipeline 和 your reward code。下面沿图解释这些职责;具体的奖励与发布策略是工程建议,不代表 Cloudflare 已公开的产品实现。
先区分两条循环。图中橙色区域是训练:当前模型给出候选决策,按需运行任务并评分,训练器据此更新参数。外面的虚线是生产反馈:选中的模型上线,遇到新流量,结果再回到采集和数据准备阶段。
训练可以在离线环境迭代,生产则必须等待真实业务结果。训练可以反复优化同一批任务;生产反馈需要等真实结果出现,才能检验训练奖励与线上目标是否一致;离线审查也可以提前发现部分奖励漏洞。把它们连起来,并不意味着生产中的每条反馈都会立即触发一次权重更新。
Gateway 采集的是行为,数据流水线才把行为变成任务
左上角 CAPTURE 负责记录生产请求与响应。它能告诉我们模型看了什么、答了什么,却未必知道答得对不对。图中 Logs alone are not labels 是整个流程最容易低估的一句。
以客服派单为例:日志记下模型选择技术支持;后续工单被转到财务,最终发现是退款规则争议。只学习最初的响应,就会重复旧模型的错误。需要把工单最终处理结果与原始请求关联起来,才能形成可用的纠错信号。
PREPARE 因而承担两件事:整理可重放的任务,以及定义怎样判断表现。对于这个例子,任务应保留派单当时可见的工单内容、问题与候选部门;最终处理部门用于评分,不能提前放入模型输入。否则模型在训练里直接读到了答案,离线成绩会失真。
数据还应按事件或时间拆分训练与评测。如果同一事故的重复工单一部分进训练、一部分进测试,模型记住事故描述也可能取得好成绩,却不能证明它能处理下一次事故。这是业务数据准备的问题,换一个更强训练器也无法补救。
Workers AI 负责提出决策,Containers 负责检验后果
图里的 GENERATE 是从当前策略采样动作或响应。这属于训练阶段:采样器可以依据模型返回的候选概率选择动作,再交给环境评分;正常线上推理并不因此自动执行训练任务。这里的策略就是当前模型给定材料后如何分配候选概率;对 Clef 而言,动作可以是选择某个部门或事故等级,无须理解成生成一大段文字。训练中产生的候选及其执行结果,常被称为 rollout,意思是让当前策略实际走一遍任务。
下一格 EXECUTE + SCORE 把两种工作放在一起:在需要时运行工具、测试或模拟环境;再由奖励代码计算这个候选表现怎样。Containers 提供执行环境,业务奖励代码提供判据。图中没有说所有任务都必须调用工具:有参考标签的分类题,可以直接评分。
仍以派单为例,只核对最终部门是一种奖励;如果还要优化解决效率,则可能需要转派次数、响应延迟和最终解决结果。后一种目标更贴近业务,但也更难归因:处理快可能来自当天人手充足,并非模型派得更好。历史日志通常只记录实际选择的部门产生的结果,也没有展示其他部门会怎样处理同一张工单。
因此,拿历史案例重放,能够验证候选与已有证据是否一致;它不能凭空得到所有未执行动作的真实后果。需要模拟器、人工判断或受控的线上实验来补上这些缺口,具体选择取决于任务。
尤其不能把“成功调用工具”直接等同于“业务任务成功”。模型可能顺利关闭了工单,却没有解决用户问题。如果奖励只检查关闭状态,训练就会推动模型更积极地关单。奖励代码定义了模型会被鼓励做什么,包括我们没打算鼓励的捷径。
Trainer 才更新参数,推理日志不会自行变成学习
UPDATE WEIGHTS 单独占了一格:训练器计算强化学习损失与梯度,再更新可训练参数。梯度可以理解为指出参数该往哪个方向调整的数值信号。容器给出的奖励只是评价结果,还需要训练算法把评价转成参数调整。
这也是三件常被混淆的事的区别:保存更多日志,增加了可用材料;修改提示词,改变了下一次输入;训练更新权重,才改变模型参数。前两项都可能改善系统表现,但不会自动完成图中的权重更新。
橙色区域标为循环,不过图上没有把训练器回到 GENERATE 的箭头画出来。下面是对一般训练流程的解释,图本身没有展示这条回路:后续轮次应使用更新后的策略继续生成候选,或采用与训练算法兼容的数据复用方式。具体怎样采样、多久更新、怎样处理旧策略数据,这张图没有交代,不能据此推断它使用某个特定强化学习算法。
同样,Update weights 不等于必须全量更新 Qwen 主干。前文所述 Clef 训练使用冻结主干、学习适配器和评分头;这张概念图没有进一步规定客户微调时开放哪些参数。因此,仅凭这张图还无法复现训练。
Selected checkpoint 是一次选择,训练结束不等于应该上线
训练器下面写的是 Selected checkpoint,随后才进入部署。checkpoint 是某个训练时刻保存的参数快照;这里的 selected 提醒我们,需要从训练结果里挑选适合生产的一版。
图没有展开选择条件。一个合理的发布门槛应同时检查业务错误、概率校准、延迟以及原有能力是否退化,而不能只看训练奖励最高。奖励上升可能来自模型学会利用评分漏洞;领域派单变准,也可能伴随“信息不足”识别变差。
部署阶段的 Workers AI 加 BYO Model,表示由托管推理平台服务选中的模型;它承担生产推理,不能替代上面的训练器。原文也明确说明,最初提供的是工程师团队协助的微调服务,自助平台属于后续方向。这张流程图展示职责,不能作为所有模块当时已全面开放的证明。
实际发布时,我会把任务数据版本、奖励代码版本、模型快照和线上表现关联起来。否则出现一次错误,只知道模型版本,很难分清是训练样本、奖励逻辑还是服务配置发生了变化。
最外层反馈要把失败和人工接管一起带回来
虚线标着 New production traffic + feedback:上线之后的新材料和结果,再次回到采集与准备阶段。它的作用是让下一轮训练接触真实变化,例如新的故障类型、业务规则变动和模型从未见过的表达。
但生产结果会受当前模型选择影响。模型只自动处理简单工单,困难工单都转人工;如果流水线只回收自动处理成功的案例,下一轮看到的世界就会越来越简单。人工改派、用户重新打开工单、模型拒绝自动处理的案例,都应进入后续审查。
在这条派单流程里,整个闭环可以落成一条可追溯记录:当时输入与候选项、模型概率、程序采取的动作、人工修改、最终结果,以及这些记录对应的模型和奖励版本。生产请求提供问题,后续结果提供纠错依据,训练器才能把纠错转成下一版参数。
我对这张图的判断是:Cloudflare 把采集、推理、执行、训练和部署串成了平台路径,但业务方仍然必须定义什么算成功。如果奖励只认关单、不认问题解决,这套流程就可能不断产出更擅长关单的模型。
先决定哪些判断允许自动执行
Clef 把已知答案集合里的语义判断做成了直接评分接口,适合放在工作流的路由和筛选环节。联合评分头负责理解材料,程序负责检查权限、解释概率并决定动作。
接入前,先选一条可撤回的派单流程,把现有样本中的关键事实、候选项和人工结果整理出来。评测时同时看错误类型、慢请求和被转人工的比例;保留完整概率分布,并验证增加问题后是否发生输入截断。比较联合评分影响时,先把输入控制在预算内;测试截断时,固定问题集合再逐步加长材料,避免把两种影响混在一起。
如果只能先改一个地方,就检查数据库是否只存了 score。把候选分布也留下来,才有机会分清“确定中等”与“低高各半”。
参考来源
- 工程发布:Introducing Clef,本文评测表与训练描述的来源。
- 服务接口:Workers AI Clef 文档,上下文和输入处理约束。
- 模型与用法:Cloudflare/Clef 模型卡。
- 固定版本源码:joint_schema_model.py,a20e258,本文核对的编码、评分和响应转换实现。