Avi Chawla(Daily Dose of DS 联合创始人)写了一篇 KV Cache Engineering for LLM Serving,把 12 种 KV cache 优化技术按「它减的是缓存公式里的哪一项」归成一张表。这个切法比常见的「技术清单」高明——清单让你记 12 个名字,公式让你知道它们为什么不能互相替代。
但他的每个技术都只配一段玩具代码(
numpy几行,或者一条 vLLM 命令)。我想知道的是:这 12 项里,哪些我能在自己的笔记本上验证,哪些只能选择相信论文? 于是我在一台 24GB 的 M5 Pro 上用 llama.cpp 把能验的那部分真跑了一遍。结论先给:他的缓存公式对到兆字节(实测 224 / 896 / 1792 MiB,手算一分不差)。但他说量化「大约省一半」的地方,我实测是省 47%,而那 3% 的差额正好是他自己文中提了一句、却没有量化的 scale 元数据。
本文图片版权说明:下面 5 张架构图全部出自 Avi Chawla 的原文,我通过原站 CDN 引用、未做修改,仅用于解说与评注;每张图下方单独标注。图的版权属于原作者,想看完整的 12 张图请直接读原文。文中的实测数字与手算是我自己的,与原作者无关(他不该为我机器上的数字背书)。
名词速查
| 术语 | 一句话解释 |
|---|---|
| KV cache | 注意力算过的 K/V 存下来,避免给历史 token 重算;代价是显存随上下文线性涨。公式推导见站内旧文 |
| prefill / decode | 一次性读完输入 vs 之后逐 token 生成。vLLM 里怎么调度 |
| GQA / MQA / MHA | 一层里有几套 K/V:MHA 每个 query 头一套,MQA 全层共享一套,GQA 分组共享。旧文算过 GQA 省 7 倍 |
| MLA(潜在注意力) | 不存完整 K/V,存一个低维潜在向量,用时投影回来。DeepSeek 的 CSA2 就走这条路 |
| SWA(滑动窗口) | 某些层只看最近 n 个 token,缓存封顶在 n,不随上下文涨 |
| 量化与 scale | 把数值压到 8 位或 4 位存。压完动态范围不够,所以每若干个值还要额外存一个缩放系数——这篇文章的主角就是这个额外开销 |
| 驱逐(eviction) | 缓存给定预算,超了就丢掉一部分 token 的 K/V。丢错了就是永久失忆 |
| PagedAttention / 前缀复用 | 前者把缓存切成等长块避免碎片,后者让相同前缀的请求共用块。vLLM 源码里的实现 |
这篇和站内旧文的分工:《KV cache 那笔账》推过公式本身、GQA 为什么省 7 倍、以及 100 并发怎么变成 11.7GB。那些这里不重讲,直接回链。这篇的增量只有两件:Avi 的 12 项分类框架,和我实测出来的那几个和文章对不上的数字。
一、公式:五个可以下手的项
他给的原始缓存公式:
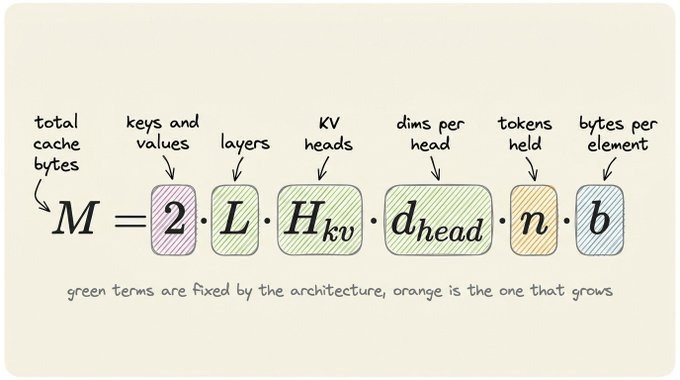
图:Avi Chawla,原载 KV Cache Engineering for LLM Serving
写成一行:
开头那个 2 是「K 和 V 各一份」。他这篇文章真正的洞察是:这个公式有五个自变量,每一项都有一族技术专门减它,而减不同项的技术可以叠乘,减同一项的不行。
| 减哪一项 | 技术 | 能否运行时开启 |
|---|---|---|
| GQA / MQA | ❌ 要训练 | |
| (唯一缓存层数) | Cross-layer attention (CLA) | ❌ 要训练 |
| 滑动窗口、驱逐(H2O / SnapKV / PyramidKV) | 窗口 ❌ 要训练;驱逐 ✅ | |
| (存储宽度) | MLA | ❌ 要训练 |
| bytes per value | 量化(FP8 / KIVI) | ✅ |
| 以上都不减,只减浪费 | PagedAttention、前缀复用、卸载 | ✅ |
| 以上都不减,只减读取量 | 压缩稀疏注意力、Quest | 稀疏读 ✅;压缩 ❌ |
第一行那三种布局,他画得比文字清楚——MHA 每个 query 头配一套 K/V,MQA 全层挤到一套,GQA 分组共享:
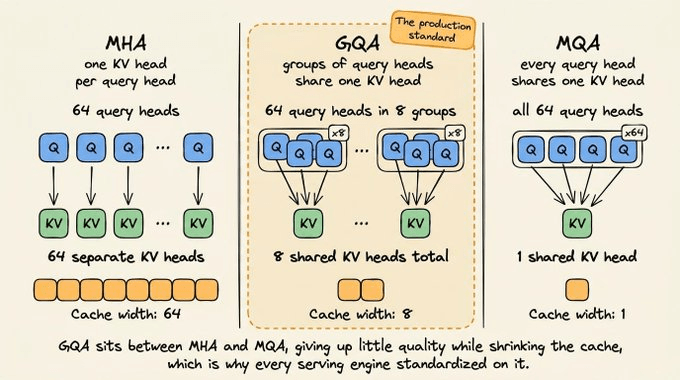
图:Avi Chawla,原载 KV Cache Engineering for LLM Serving。这三者为什么省 7 倍,站内旧文逐项算过,这里不重复。
减 那一项同理——全注意力每层都要留全序列,滑动窗口把某些层封顶在固定槽位数:
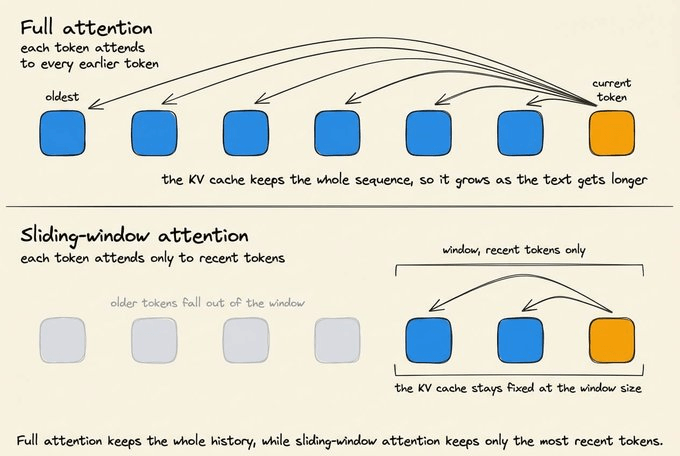
图:Avi Chawla,原载 KV Cache Engineering for LLM Serving
他举的例子是 Gemma 3:五个局部层跟一个全局层的循环,局部窗口 1024,全局层支持全部 128K(他的转述,我未核 Gemma 3 的配置)。这个「几层局部配一层全局」的模式,和我上一篇拆 DeepSeek V4.1 时看到的 sliding_window=128 打头两层是同一个思路的不同参数。
最后两行是他文中我认为最值钱的一句话,值得原样引下来:
A faster attention kernel doesn’t create room for another sequence unless it also stores fewer bytes. (注意力算得再快,只要它没少存字节,就腾不出位置多跑一条会话。)
这句话把「省显存」和「跑得快」彻底分开了。Quest 这类技术把每步读的缓存砍掉一半,但一个字节都没释放——它优化的是带宽不是容量。GPU 满了的时候,Quest 救不了你。
他那张 12 项总表就是按这个逻辑排的:
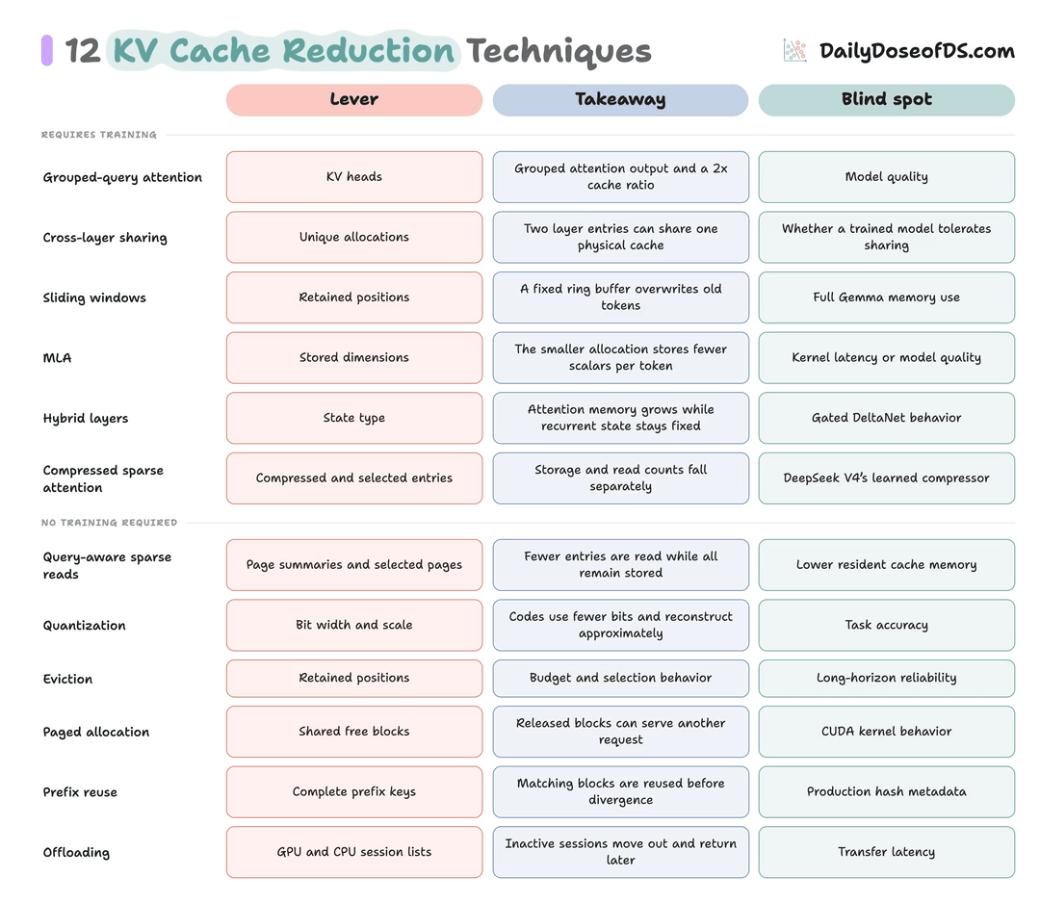
图:Avi Chawla,原载 KV Cache Engineering for LLM Serving。这张图在原文里出现了两次(Technique map 和文末总结),我核过 SHA256,是同一张。
二、我在 M5 Pro 上实测了能验的三项
环境:Apple M5 Pro / 24 GB 统一内存,llama.cpp build b9630-8ed274ef4,模型 Qwen2.5-7B-Instruct-Q4_K_M。
先从 --verbose 日志里拿到这个模型的真实形状(不是查文档,是从加载日志读的):
print_info: n_layer       = 28
print_info: n_head_kv     = 4
print_info: n_embd_head_k = 128
验证一:公式对到兆字节
llama.cpp 的 --verbose 会打一张内存分解表,中间那项 context 就是 KV cache:
| memory breakdown [MiB] | total    free    self   model   context   compute  |
|  - MTL0 (Apple M5 Pro) | 18186 = 13481 + (4703 =  4168 +     224 +     311) |
4703 = 4168(模型权重)+ 224(KV cache)+ 311(计算缓冲)。按公式手算 4096 上下文:
实测 224 MiB,一分不差。 换三个上下文长度都对:
| 上下文 | 手算 | 实测 |
|---|---|---|
| 4,096 | 224.0 MiB | 224 MiB |
| 16,384 | 896.0 MiB | 896 MiB |
| 32,768 | 1792.0 MiB | 1792 MiB |
线性增长这件事,纸上写一百遍不如亲眼看它从 224 涨到 1792。
顺手也验了旧文的连续性:旧文算的是 2048 长度 ≈ 117MB,我这里 4096 是 224 MiB —— 224 MiB / 2 = 112 MiB = 117.4 MB(十进制),对得上。
验证二:量化省的不是一半,是 47%
这是我实测和他文章对不上的地方,也是这篇最值钱的一段。
他的原文说:
BF16 stores each number with 16 bits. FP8 uses 8 bits, so its raw payload is roughly half as large. A 4-bit format cuts the payload to 25%.
然后补了一句「A real cache also stores scale metadata」,但没算这句话值多少。我实测:
| K/V 类型 | 实测 KV(4096 ctx) | 占 f16 的 | 文章的说法 |
|---|---|---|---|
| f16 | 224 MiB | 100% | 基准 |
| q8_0 | 119 MiB | 53.1% | 「大约一半」 |
| q4_0 | 63 MiB | 28.1% | 「25%」 |
差额是可以手算出来的。llama.cpp 的 q8_0 块格式是每 32 个值一组,存 32 个 int8 + 一个 fp16 的 scale,也就是 32 × 1 + 2 = 34 字节装 32 个值:
q4_0 是 32 × 0.5 + 2 = 18 字节装 32 个值:
拿 8.5 和 4.5 bit 回代公式:预测 119.0 MiB 和 63.0 MiB,实测 119 和 63。
所以「4-bit 省到 25%」这句话在任何分块量化的实现里都不成立,真实值是 28.1%,多出来的 3.1 个百分点就是 scale。这不是他算错了,是「raw payload」和「实际占用」的区别——但对做容量规划的人来说,12% 的相对误差(28.1 vs 25)足以让你把一台机器规划错。
验证三:这 47% 的显存,代价是 5% 的吞吐
省显存要付什么?他文章没给数字。我用 llama-bench 跑了两轮,每轮 3 次重复,每次之间插 25 秒冷却(为什么要冷却见下一节):
| K/V 类型 | 第 1 轮 tg128 | 第 2 轮 tg128 | 显存 |
|---|---|---|---|
| f16 | 57.21 ± 1.02 t/s | 58.09 ± 0.89 t/s | 224 MiB |
| q8_0 | 55.11 ± 0.85 t/s | 55.49 ± 0.54 t/s | 119 MiB |
| q4_0 | 54.55 ± 0.48 t/s | 54.91 ± 0.74 t/s | 63 MiB |
两轮一致,单调。KV 缓存压到 28%,decode 吞吐只掉约 5%。 在这台机器上这个交换非常划算——如果你的瓶颈是「能同时开几个长会话」,几乎应该默认开 q8_0。
(注意:这只测了速度和字节,没测质量。量化误差对输出的影响要用你自己的任务评测,我没做。)
我差点发出去一个假的 6 倍变慢
第一版测量我是连着跑的,没插冷却,结果拿到这组数:
f16  fa=0  tg128: 57.83 ± 0.57
f16  fa=1  tg128:  9.39 ± 0.22      ← ???
q4_0 fa=1  tg128: 51.91 ± 0.47
f16 + flash attention 只有 9.39 t/s,比不开 flash attention 慢 6 倍,而 q4_0 又回到 51.91。非单调——开了 flash attention 反而是最慢的,而更激进的量化又变快了,这在机制上讲不通。
我当时的第一反应是「Metal 的 FA 解码路径有坑」,差点就这么写进文章。停下来加了 60 秒冷却重测两轮:
round 1:  f16 fa=0: 53.74 ± 0.51   f16 fa=1: 55.59 ± 0.39
round 2:  f16 fa=0: 56.10 ± 0.70   f16 fa=1: 58.31 ± 0.01
flash attention 根本没有负面影响,那个 9.39 是热节流。 前面连跑了十几次 7B 推理,机器已经烫了,恰好轮到 f16 fa=1 那一格吃到了降频。
教训很具体:笔记本上做推理 benchmark,「非单调」就是数据坏了的信号。机制上说不通的结果不要急着找机制解释,先怀疑测量。我现在的规矩是——任何一组要发布的数字,必须换个顺序再跑一轮,两轮不一致就全部作废。
另外两个坑
llama-cli不能再做一次性推理了。 build b9630 里它是纯对话模式,-no-cnv被移除(报错原话:--no-conversation is not supported by llama-cli, please use llama-completion instead)。更糟的是 stdin 关闭时它会无限打印提示符——我的日志涨到 730 MB 才发现。一次性跑用llama-completion。- 量化 V cache 必须开 flash attention。
llama-bench -ctv q8_0不带-fa 1会直接failed to create context。他文章里那条 vLLM 的--kv-cache-dtype fp8看着一键就能开,换到 llama.cpp 要多一个前置条件。
三、他那几个招牌数字,我复算了一遍
二手数字我的习惯是回算一遍再引用。他文中四个关键数字全部对上:
| 他的说法 | 我按公式复算 | 结论 |
|---|---|---|
| Llama 3.1 70B @128K ≈ 40 GB KV | 80 层 / 8 KV 头 / 128 → 40.0 GiB | ✅ |
| 同形状换 64 KV 头(MHA)要 320 GB | → 320 GiB | ✅ |
| Qwen3-Next 12 个注意力层 @128K ≈ 3 GB | 12 层 / 2 KV 头 / 256 → 3.0 GiB | ✅ |
| 全 48 层都用注意力则 12 GB | → 12.0 GiB | ✅ |
所以他的公式和引用是可靠的,可以放心当地基用。三档证据交代清楚:上表是我手算核对;下面这些是他转述的论文报告值,我一个都没复现——CLA 论文的再省 2 倍、Quest 的 7.03 倍自注意力延迟下降、KIVI 的 2.6 倍峰值内存下降、SnapKV 的 8.2 倍、PyramidKV 保留 12% 缓存持平、PagedAttention 的 2–4 倍吞吐。这些数字我只是搬运,想用请自己回原论文核。
四、能叠乘,但每一步都在换东西
他给了一个从 40 GB 往下压的例子:
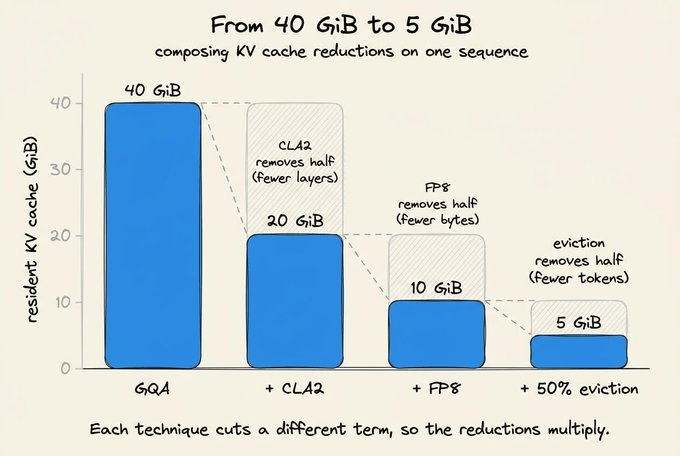
图:Avi Chawla,原载 KV Cache Engineering for LLM Serving
40 GB →(CLA2 减半唯一层数)20 GB →(FP8 减半位宽)10 GB →(50% token 预算)5 GB。
乘法能成立,是因为这三步减的是公式里三个不同的项。但他很诚实地紧接着写了每一步的代价,我把它翻译成一张「坏掉会怎样」表:
| 这一步 | 换掉的是什么 | 坏掉会怎样 |
|---|---|---|
| CLA2 减半层数 | 要重新训练 | 拿现成 checkpoint 强行让两层共用缓存 = 模型算的不再是它训练时那个函数,输出直接崩坏 |
| FP8 减半位宽 | 量化误差 | 长上下文里的细节检索先失准;且实际只省到 53%,不是 50%(上面实测) |
| 50% token 预算 | 丢掉一半上下文 | 现在看着不重要的 tool 结果,五轮之后突然要用——永久失忆 |
第三行是他文中我最认同的一条判断,值得单独拎出来:驱逐的评测不能只看 Needle-in-a-Haystack。他的原话是要用「完整的 agent 轨迹 + 延迟引用 + 结构化 prompt」来测。理由很实在——大海捞针测的是「一根针还在不在」,而 agent 场景的失效模式是「第 3 轮的 tool 输出在第 8 轮才被引用」,这种延迟依赖大海捞针根本测不到。
五、为什么只能这么分类
根本约束:KV cache 的字节数决定单机能并发多少条会话,而这个字节数是五个因子的乘积——所以任何优化必须挑明它动的是哪一个因子,否则你无法预测两个技术能不能叠加。
这句话可反驳,所以说清它不成立会怎样:如果缓存大小不是乘积形式(比如是某个不可分解的黑箱),那这 12 种技术就只能一个个试,没有任何先验能告诉你 GQA + FP8 能叠乘、而 GQA + MQA 不能。是乘法结构本身让「分类」这个动作有意义,也是他这篇文章比同类清单高一档的原因。
崩点。 换成最朴素的做法——MHA,每层每个 query 头都存自己的 K/V。我这台机器上的 Qwen2.5-7B 是 28 个 query 头 / 4 个 KV 头,GQA 恰好省 7 倍。32K 上下文下:
- GQA(4 KV 头):1792 MiB(实测)
- 若是 MHA(28 KV 头):12,544 MiB = 12.25 GiB(手算)
这台机器总共 24 GB 统一内存,模型权重已经吃掉 4.2 GB。MHA 版本的 KV cache 单独要吃掉 51% 的总内存——一条会话就把机器占满,遑论并发。崩点不在速度,在「开第二个会话就 OOM」。
共同祖先。 这 12 项里有 7 项(GQA、MQA、CLA、MLA、SWA、驱逐、量化)本质上是同一个老问题的不同答案:哪些信息可以不存,或者存得更糙而不影响结果? 这是缓存设计从 CPU cache 时代就有的母题——容量、关联度、替换策略、脏位宽度。GQA 是降关联度,SWA 是缩容量,驱逐是替换策略,量化是降字长。剩下 5 项(分页、前缀复用、卸载、Quest、压缩稀疏)则是操作系统那套老办法:分页、去重、换页到二级存储、以及只把工作集读进来。
这也解释了为什么「运行时能不能开」这一列分得那么干净:动模型的(前 7 项里的 6 项)要训练,动内存管理的(后 5 项)不用。因为前者改的是函数本身,后者只改这个函数的存储布局。
六、收口:三行带走
- 约束:KV 字节 = 层数 × KV 头数 × 头宽 × token 数 × 每值字节,五项各有一族技术;减不同项能叠乘,减同一项不能。
- 崩点:我这台 24GB 机器上,Qwen2.5-7B 若用 MHA,32K 上下文的 KV 要 12.25 GiB(占总内存 51%),一条会话就占满——GQA 那 7 倍不是优化,是能不能跑的前提。
- 别信「省一半」:分块量化的真实比例是 53.1%(q8_0)和 28.1%(q4_0),差额是 scale 元数据。做容量规划用实测值,不用宣传值。
五分钟实验:在你自己的机器上把 224 MiB 看出来
这篇的所有显存数字都来自一条命令,你可以现在就复现(前提:装了 llama.cpp,手上有任意 GGUF 模型;实际耗时约 3 分钟,其中大部分是模型加载):
# 看 KV cache 到底占多少:读 memory breakdown 表的 context 那一列
llama-completion -m <你的模型>.gguf -c 4096 -n 1 -p "hi" \
  --verbose < /dev/null 2>&1 | grep -A2 "memory breakdown"
输出里 (总 = 模型 + context + compute) 的 context 就是 KV cache。然后把 -c 4096 换成 -c 16384,看它是不是正好涨 4 倍;再加 --cache-type-k q8_0 --cache-type-v q8_0,看它是不是落在 53% 而不是 50%。
三条命令,你就有了自己机器上的真实数字,而不是别人博客里的数字——包括我这篇。
参考来源
本文消化的原文
- Avi Chawla, KV Cache Engineering for LLM Serving(2026-09-06)— 本文的 12 项分类框架与 5 张配图均出自此文
- 作者主页:@_avichawla / Daily Dose of DS
- 他同主题的另两篇(本文未展开):KV Caching in LLMs, Explained Visually、KV vs Prefix vs Prompt vs Semantic Caching
他引用、我未复现的论文(想用请回原文核)
- GQA、Cross-Layer Attention (CLA)、MLA (DeepSeek-V2)、Quest、KIVI、H2O、SnapKV、PyramidKV、PagedAttention (vLLM)、Jamba
站内相关
- KV cache 那笔账:为什么 Qwen2.5-7B 在 2048 长度下大约是 117MB — 公式逐项推导、GQA 省 7 倍、100 并发的账,本文不重讲
- 两张架构图里藏着 890 字节:DeepSeek V4.1 Flash 的 43 层排班表 — 他第 4、6 项(MLA、压缩稀疏注意力)在真实模型里长什么样
- vLLM APC 六问:从 block hash 到 free/evict — 他第 10、11 项(分页、前缀复用)的源码级实现
- SGLang 内幕:RadixAttention、超售调度与期货流水线 — 前缀复用的另一种组织方式