这张图最容易让人记住的是七个年份,最值得记住的却是四次换轨:机器先学会回应,再学会表示,然后学会自己改参数,最后才获得把海量关系放到一次计算里的能力。
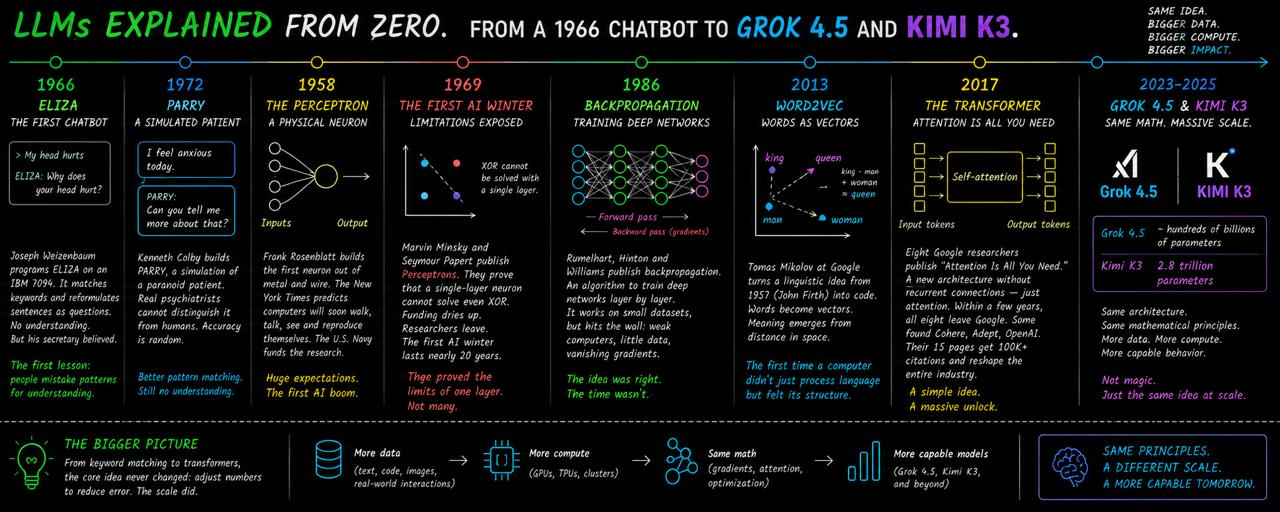
原图是一张很好的视觉索引。本文不逐格复述,而是校正其中的时间与因果,再抽出一套以后看新模型也能复用的框架。
先给结论:现代大模型之所以长成今天这种“巨大的、可微的、以矩阵运算为主”的样子,是因为梯度下降只能优化可微计算,而训练和推理又必须尽可能并行。
如果没有这两个约束,模型未必需要 Transformer,也未必需要数万亿参数。反过来,只增加参数、却不解决表示、学习和信息路由,得到的只会是更贵的旧机器。
名词速查
| 术语 | 一句话解释 |
|---|---|
| 参数 | 模型训练时会被改动的数字;推理时,它们共同决定下一个 token 的概率 |
| token | 模型读写文本时使用的小片段,可以是字、词或词的一部分 |
| 向量 | 一排数字;把词变成向量,就是把“意思”放进可计算的坐标里 |
| 梯度 | 告诉每个参数“往哪边改,误差会变小”的方向提示 |
| 反向传播 | 把输出端的误差逐层传回去,为各层参数算出梯度 |
| 自注意力 | 让序列里的每个 token 按相关性直接读取其他 token 的信息 |
| MoE | Mixture of Experts,混合专家;每次只激活模型中的一小部分参数 |
读懂本文只需要这七个概念。向量、梯度和注意力的数学细节,站内已有《初中数学读懂 Attention Is All You Need》;这里不重复推公式,只看它们各自拆掉了哪道墙。
先别急着背年份:图里有三处需要校正
第一,时间顺序画乱了一处:1958 年的感知机被放在 1972 年的 PARRY 之后。它不影响单格内容,却提醒我:横轴看着像时间轴,不等于能直接当年表引用。
第二,把 1969 年《Perceptrons》直接写成“第一次 AI 寒冬”,因果压得太扁。Minsky 与 Papert 确实证明了若干单层感知机的能力边界;但书中讨论的是特定结构,而不是神经网络的一切可能结构。MIT Press 的书介甚至明确写着,书在证明某些不可能性的同时,也强调未来进展的前景。资金、算力、承诺落空与研究路线转移共同塑造了寒冬,不是一道 XOR 题单独关掉了整个领域。
第三,最右侧标成“2023–2025”已经过时。官方页面显示,Grok 4.5发布于 2026 年 7 月 16 日,Kimi K3则在 2026 年 7 月 27 日开放权重与技术报告。图上写 Kimi K3 有 2.8 万亿参数,这个数字能从官方材料核到;但“同一架构,只是规模不同”说得太满——Kimi K3 明确使用 Kimi Delta Attention、Attention Residuals 与 MoE,不能把两家模型压成同一张结构图。
所以我会把它当作地图,不当作史料。地图负责指路,史料负责定案。
一张更耐用的地图:四道门槛
按年份记 AI 史,新模型一发布,地图就要重画。按瓶颈记,新的名字只是落到旧坐标里。
| 门槛 | 要解决的问题 | 关键转折 | 没跨过去会怎样 |
|---|---|---|---|
| 表示 | 怎样把语言变成机器能比较的东西 | 关键词 → 特征 → 词向量 | 换个说法,机器就像第一次见 |
| 学习 | 怎样把一次答错变成全网参数的改进 | 人写规则 → 感知机 → 反向传播 | 知道错了,却不知道该改哪一层 |
| 路由 | 一段话里的信息怎样彼此相遇 | 顺序传递 → 自注意力 | 长距离关系要经过很长的传话链 |
| 规模 | 怎样让数据、算力和参数继续增长 | 并行训练、MoE、分布式系统 | 方法在小实验里成立,成本先把它压垮 |
这四个杠杆不是互相替代。表示变好,样本效率会上升;学习信号变好,参数更新更准;路由变短,长上下文更容易建模;规模变大,容量与训练成本一起上升。今天所谓“更强模型”,通常是四条轴同时移动,而不是参数量一条轴拉到头。
第一站:ELIZA 解决的是“像在对话”,不是理解
1966 年的 ELIZA 会识别关键词,再把用户的话套进重写模板。用户说“我头痛”,程序抓住“我……”或“……痛”这样的模式,可能回一句“为什么你会头痛?”
它的价值不是“第一个懂语言的机器”,而是清楚展示了:只要回应形式足够像,人会主动把理解投射给程序。 Weizenbaum 在 ELIZA 原始论文里描述的就是一种关键词分解与重组机制。
图里那句 “People mistake patterns for understanding” 很准。今天判断一个聊天产品,也仍然要问同一个问题:它是在调用稳定的内部表示,还是只对当前措辞做了漂亮反射?
第二站:感知机有了学习,但表示仍是一刀切
Rosenblatt 的感知机比模板匹配多了一件关键能力:它能从样本中调整权重。两个输入 x1、x2 各乘一个权重,再加偏置;结果过线就输出 1,不过线就输出 0。
它像拿一把直尺在平面上分两类点。AND 能一刀切开,XOR 不行——XOR 的两个 1 分处在对角,任何直线都会把至少一个点分错。
我用一个无依赖的 Python 小实验搜了 w1、w2、b ∈ [-5,5] 的全部 1331 组整数参数。把下面代码保存成 xor_check.py,运行 python3 xor_check.py 即可复现:
from itertools import product

def step(z):
    return int(z >= 0)

def separators(rule, radius=5):
    found = []
    for w1, w2, b in product(range(-radius, radius + 1), repeat=3):
        if all(step(w1*x1 + w2*x2 + b) == rule(x1, x2)
               for x1, x2 in product((0, 1), repeat=2)):
            found.append((w1, w2, b))
    return found

print("AND separators:", len(separators(lambda x1, x2: x1 & x2)))
print("XOR separators:", len(separators(lambda x1, x2: x1 ^ x2)))
本机实跑输出:
AND separators: 20
XOR separators: 0
有限区间搜索本身不是数学证明,但 XOR 的矛盾可以用四行不等式补上:两个单独为 1 的输入都要越过阈值,它们相加后理应更大;可 XOR 又要求 (1,1) 输出 0。四个条件无法同时成立。
有趣的是,加一层就够。第一层分别算 OR 与 NAND,第二层再对它们做 AND:
x1 x2 | OR NAND | two-layer XOR
0  0  | 0    1    | 0
0  1  | 1    1    | 1
1  0  | 1    1    | 1
1 1 | 1 0 | 0这就是“深度”的第一份直觉:隐藏层不是多装几块同样的积木,而是先把原问题改画到一个更容易切开的空间。
第三站:反向传播解决“每一层该背多少锅”
多层网络能表示 XOR,不等于人知道怎样训练它。输出错了,最后一层容易改;越往前,每个参数对最终错误只负一小部分责任,谁该改多少并不直观。
反向传播做的是“责任分摊”。先正向算答案和误差,再从后往前使用链式法则,把误差对每个参数的影响算出来。1986 年 Rumelhart、Hinton 与 Williams 的论文清楚描述了这个过程:反复调整连接权重,使实际输出与目标输出的差异变小,隐藏单元会由此学出任务中的重要特征。
它拆掉的是学习门槛,但当年的数据、算力和训练技巧还不够。图里“主意是对的,时代还没到”比“1986 年突然发明深度学习”更接近事实。
第四站:Word2Vec 把“意思”变成了相对位置
模板系统把词当开关:看到 head 走一条规则,看到 pain 走另一条。Word2Vec 的关键变化,是让词变成一排可学习的数字,并用上下文训练这些数字。
结果不是给每个词附一份词典释义,而是让用法相近的词落到相近位置。king 与 queen 的关系、man 与 woman 的关系,开始能用向量方向近似表达。Mikolov 等人在 2013 年的论文中展示了用大规模语料高效学习连续词向量的方法。
这里跨过的是表示门槛:语言第一次不只是一串离散符号,而成了可比较、可插值、可被梯度推动的几何空间。 更完整的“知识如何进入权重”可以接着读《大模型为什么能学会知识,知识又存在哪里》。
第五站:Transformer 缩短了信息之间的路
在循环神经网络里,第一个词的信息要一路传到最后一个词,计算也天然按顺序排队。句子越长,传话链越长;GPU 再多,也很难把同一条序列完全并行展开。
自注意力换了一种路由方式:每个 token 都可以直接给其他 token 打相关性分数,再按分数汇总信息。2017 年 《Attention Is All You Need》提出仅基于注意力的 Transformer,去掉了循环与卷积,并把“更易并行训练”写进了核心结果。
它并没有发明向量,也没有发明反向传播。它做的是把已经存在的零件排成一条更适合现代硬件的高速公路:
flowchart LR
  A[文本切成 token] --> B[向量表示]
  B --> C[自注意力路由信息]
  C --> D[前向得到预测]
  D --> E[误差]
  E --> F[反向传播改参数]
  F --> C
如果没有并行计算这条物理约束,Transformer 未必会赢得如此彻底。若仍用顺序传递,最朴素的方案先崩在训练吞吐:你可以加更多数据,却无法同比例地让更多计算单元同时工作。
最后一站:规模不是第五道魔法,而是前四道门槛的乘法
图的底部把现代模型归纳成“更多数据 → 更多算力 → 同样数学 → 更强模型”,方向对,但少了几个限定词。
首先,参数多不等于每次计算都把参数全用一遍。Kimi 官方材料写明 K3 是 2.8 万亿参数的 MoE,每次只激活部分专家。总参数量更像仓库容量,激活参数量才更接近一次请求实际搬了多少货。
其次,数学骨架延续,不代表架构静止。注意力变体、MoE 路由、长上下文、数据配方、强化学习与分布式训练都会改变“同一份算力能换回多少能力”。Grok 4.5 的官方介绍也把数据筛选、强化学习、异步训练和大规模 GPU 集群列为训练组成,而不是只报一个参数数字。
最后,聊天模型的能力已不全在权重里。搜索、代码执行、记忆、工具调用与验证器都把模型放进了更大的系统。只看模型尺寸,就像只看 CPU 晶体管数来判断整台电脑能做什么。
共同祖先:把人工规则换成可学习的中间表示
这条 60 年路线反复出现同一个老动作:不要让人直接写答案规则,先造一个可调整的中间层,再让误差反馈去塑造它。
- 感知机把规则换成权重。
- 多层网络把人工特征换成隐藏表示。
- Word2Vec 把词典关系换成向量位置。
- Transformer 把固定传递路径换成动态注意力。
- MoE 把“每次都算全部参数”换成可学习的专家路由。
这也是一条可反驳的主线:如果某个系统的中间表示不能被数据改变,或者误差无法回到产生错误的部件,它就不在这条学习路线里,只是披着 AI 外衣的固定流程。
读下一张模型图时,先问这四个问题
别先问“它有多少参数”。花五分钟,按这个顺序看:
- 表示:输入被变成了什么,哪些关系因此更容易表达?
- 学习:反馈从哪来,能不能准确传到需要改变的参数?
- 路由:信息在部件之间怎么走,最长的等待链在哪里?
- 规模:数据、显存、通信或验证成本,哪一项会先爆?
一句话带走:ELIZA 到 Kimi K3 不是“同一个点子不断放大”,而是表示、学习、路由、规模四道门槛依次松开;规模只有乘在前三项上,才会变成能力。
参考来源
论文与原始资料
- ELIZA—A Computer Program for the Study of Natural Language Communication Between Man and Machine — Joseph Weizenbaum, 1966
- The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain — Frank Rosenblatt, 1958
- Perceptrons: An Introduction to Computational Geometry — Marvin Minsky、Seymour Papert, 1969
- Learning representations by back-propagating errors — Rumelhart、Hinton、Williams, 1986
- Efficient Estimation of Word Representations in Vector Space — Mikolov et al., 2013
- Attention Is All You Need — Vaswani et al., 2017
模型官方资料
- Introducing Grok 4.5 — xAI, 2026-07-16
- Kimi K3 开放日 — Moonshot AI, 2026-07-27
本站延伸阅读